- Publicado em
De júnior a sênior: de escrever código rápido a desenhar sistemas que duram
- Autores
- Nome
- Ergito Vilanculos
No começo da carreira, um bom dia era um dia com muito código entregue. Tickets indo para "Done", pull requests mergeados, features no ar.
Sete anos depois, um bom dia é bem diferente. Às vezes, a coisa mais valiosa que eu faço é não escrever código: é fazer a pergunta que torna metade do trabalho planejado desnecessária.
Este post é sobre essa transição, de escrever código rápido para desenhar sistemas que duram, e sobre o que realmente mudou na forma como eu encaro problemas complexos.
O caminho até aqui
Senioridade não é um título que você recebe numa data específica. É a soma de contextos que te obrigam a pensar além do código na sua frente. Olhando para trás, cada etapa do meu caminho empurrou esse limite um pouco mais longe.
| Período | Contexto | O que me obrigou a aprender |
|---|---|---|
| 2019 | Estágio na PROJENITY: suporte técnico, infraestrutura de rede, primeiros projetos de software | Sistemas falham no mundo real, e alguém precisa entender por quê |
| 2020–2021 | Cofundei a Leeva Studio: produtos de marketplace e mobilidade urbana para o mercado moçambicano, com integrações de pagamento M-Pesa e e-Mola | Quando o produto é seu, todo atalho volta para você |
| 2020–2021 | Handza: um app de gestão laboratorial, construído com Clean Architecture, SOLID e TDD | Estrutura é o que permite continuar entregando rápido depois da primeira versão |
| 2021–2022 | N26: APIs backend em Java com Spring Boot e em Node.js com TypeScript, melhorias de CI/CD, discussões de arquitetura | Confiabilidade se projeta, não se adiciona depois |
| 2022–2026 | Raízen: serviços backend para mais de 10 milhões de usuários, integrações orientadas a eventos na AWS | Em escala, toda decisão de design tem um raio muito maior que o código |
Nenhum desses trabalhos veio com um manual de "como pensar como sênior". As lições vieram dos próprios problemas.
Codar rápido não é o problema
Deixa eu ser claro: escrever código rápido é uma habilidade, não um defeito. Todo bom engenheiro sênior que eu conheço ainda consegue entregar rápido quando precisa.
O problema é quando velocidade vira a única métrica. John Ousterhout chama isso de programação tática: o objetivo principal é fazer algo funcionar, e cada atalho parece inofensivo isoladamente (Ousterhout, 2018). Acumulados ao longo de meses, esses atalhos viram a complexidade que deixa todo mundo mais lento.
Ele também descreve o tactical tornado: o engenheiro prolífico que entrega features mais rápido que qualquer um e deixa para trás um rastro de código que os outros precisam desembaraçar. A gestão costuma ver um herói. O time vê a faxina.
A alternativa é a programação estratégica: código funcionando não basta; o objetivo é um bom design que também funcione. A mudança parece sutil. Na prática, muda quase tudo.
O raio de uma decisão
A forma mais clara que encontrei para descrever a diferença é o raio de uma decisão: até onde você olha antes de escrever o código.
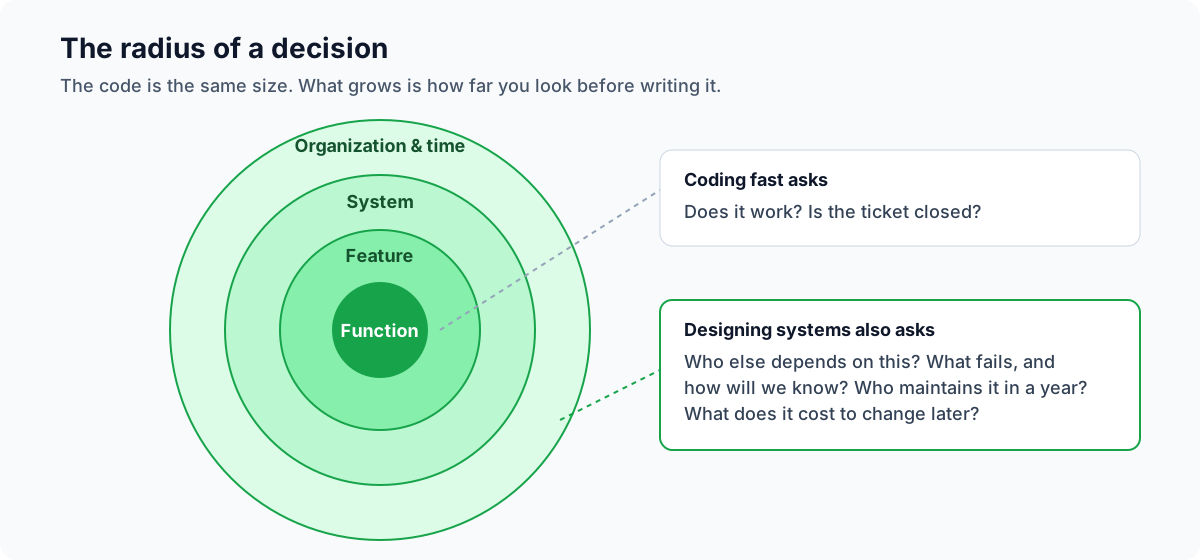
O código em si costuma ter o mesmo tamanho. O que cresce é o conjunto de perguntas:
- Quem mais depende disso? Outros serviços, outros times, os dados que vêm depois.
- O que falha, e como vamos saber? Timeouts, retries, falhas parciais, erros silenciosos.
- Quem mantém isso daqui a um ano? Provavelmente não você, e com certeza sem o contexto que você tem hoje.
- Quanto custa mudar depois? Algumas decisões são baratas de reverter. Outras, não.
O que realmente mudou
1. Da solução para o problema
Como júnior, eu recebia uma solução e implementava. Como sênior, o primeiro trabalho é entender o problema bem o suficiente para questionar a solução.
Um exemplo concreto: na Raízen, reduzimos a latência de uma API de 60 segundos para 750 milissegundos. Otimizar consultas no banco foi parte disso, o caminho óbvio. A outra parte começou com uma pergunta diferente: o usuário realmente precisa esperar tudo isso terminar?
A resposta era não. Transformar fluxos síncronos críticos em operações assíncronas mudou o problema por completo. Este é o formato da mudança, simplificado e ilustrativo, não o código original:
// Before: the request waits for the heavy work to finish
app.post('/reports', async (req, res) => {
  const report = await generateReport(req.body)
  res.json(report)
})
import { randomUUID } from 'node:crypto'
import { SQSClient, SendMessageCommand } from '@aws-sdk/client-sqs'

const sqs = new SQSClient({})

// After: accept the request, enqueue the work, answer immediately
app.post('/reports', async (req, res) => {
  const jobId = randomUUID()
  await jobs.create({ id: jobId, status: 'pending' })
  await sqs.send(
    new SendMessageCommand({
      QueueUrl: process.env.REPORTS_QUEUE_URL,
      MessageBody: JSON.stringify({ jobId, filters: req.body }),
    })
  )
  res.status(202).json({ jobId, statusUrl: `/reports/${jobId}` })
})
export async function handleReportMessage(body: string): Promise<void> {
  const { jobId, filters } = JSON.parse(body) as { jobId: string; filters: ReportFilters }

  const job = await jobs.find(jobId)
  // SQS delivers at least once, so the same message can arrive twice
  if (!job || job.status === 'done') return

  const report = await generateReport(filters)
  await jobs.complete(jobId, report)
}
O código não tem nada de sofisticado. O valor estava em reformular o problema antes de mexer nele.
TIP
Antes de otimizar algo, pergunte se isso precisa acontecer agora, aqui e para este usuário. Muitos "problemas de performance" são, na verdade, problemas de design disfarçados.
2. Das "boas práticas" para os trade-offs
Juniores costumam procurar a resposta certa. Seniores procuram a opção menos ruim para aquele contexto.
Mark Richards e Neal Ford resumem isso sem rodeios na primeira lei da arquitetura de software: tudo em arquitetura de software é um trade-off (Richards & Ford, 2020). A mudança para assíncrono é um bom exemplo. Ela resolveu a latência e trouxe custos novos:
| O que ganhamos | Com o que pagamos |
|---|---|
| Respostas rápidas, sem esperas de 60 segundos | Consistência eventual: o resultado não fica pronto na hora |
| Escala independente para o trabalho pesado | Uma fila, um worker e o estado dos jobs para operar |
| Resiliência: falhas podem ser reprocessadas | Idempotência: a mesma mensagem pode ser processada duas vezes |
| Liberdade para processar no nosso ritmo | Debug mais difícil entre fronteiras assíncronas |
Se você não consegue listar quanto uma decisão custa, ainda não terminou de tomá-la.
3. De código que funciona para sistemas operáveis
"Funciona na minha máquina" vira "funciona em produção". Depois vira "vamos saber rápido quando parar de funcionar".
Na N26, parte do meu trabalho foi melhorar a confiabilidade dos deploys com alarmes do CloudWatch que disparavam alertas no Microsoft Teams por meio de webhooks. Na Raízen, observabilidade com New Relic, Kinesis e CloudWatch fez parte de como melhoramos a confiabilidade do sistema e reduzimos os incidentes em produção em 79%.
Nenhum dos dois era trabalho de feature. Os dois deixaram os sistemas mais seguros de operar e de mudar. Hoje, a minha definição de pronto inclui perguntas que eu nunca teria feito como júnior:
- Consigo dizer, olhando um dashboard, se essa feature está saudável?
- Existe alerta para a falha que mais prejudicaria os usuários?
- Os logs são estruturados e correlacionados entre serviços?
- Os retries têm limite, e as mensagens com falha vão para algum lugar visível?
- Alguém além de mim sabe operar isso?
4. De decisões na cabeça para decisões por escrito
Como júnior, o "porquê" por trás do código vivia na minha cabeça, ou numa call que ninguém gravou. Funciona até a pessoa com o contexto sair do time, ou até você esquecer.
Michael Nygard propôs os Architecture Decision Records (ADRs): documentos curtos com título, contexto, decisão, status e consequências (Nygard, 2011). São uma das ferramentas mais baratas e com maior retorno que eu conheço. Um ADR para a mudança acima poderia ser assim:
# 7. Gerar relatórios de forma assíncrona

**Status:** Aceito

**Contexto:** A geração de relatórios leva até 60 s e roda dentro da requisição
HTTP. Os clientes estouram o timeout e tentam de novo, multiplicando a carga.

**Decisão:** Aceitar a requisição, enfileirar um job no SQS e processá-lo num
worker. Os clientes consultam o status do job.

**Consequências:** As respostas ficam rápidas. O resultado passa a ser
eventualmente consistente. Os workers precisam ser idempotentes. Precisamos
monitorar o tamanho da fila e as falhas.
Repare que as consequências repetem a tabela de trade-offs. É de propósito. Escrever uma decisão é como você prova para si mesmo que a entendeu.
5. De grandes reescritas para mudanças incrementais
O instinto júnior diante de um sistema bagunçado é reescrever. O instinto sênior é mudar um passo seguro de cada vez.
Na Raízen, contribuí com a migração do módulo de campanhas para fora do monólito, desenvolvendo um micro-frontend dedicado e um BFF (Backend-for-Frontend). O escopo importa: um módulo, com fronteiras claras, e não "reescrever a plataforma". É assim que você reduz o risco e ainda faz a arquitetura avançar.
O mesmo princípio aparece na arquitetura orientada a eventos: peças pequenas e desacopladas, que evoluem de forma independente, são mais fáceis de mudar do que uma peça grande que precisa mudar inteira de uma vez.
Duas formas de atacar o mesmo problema
Juntando tudo, a diferença fica assim:
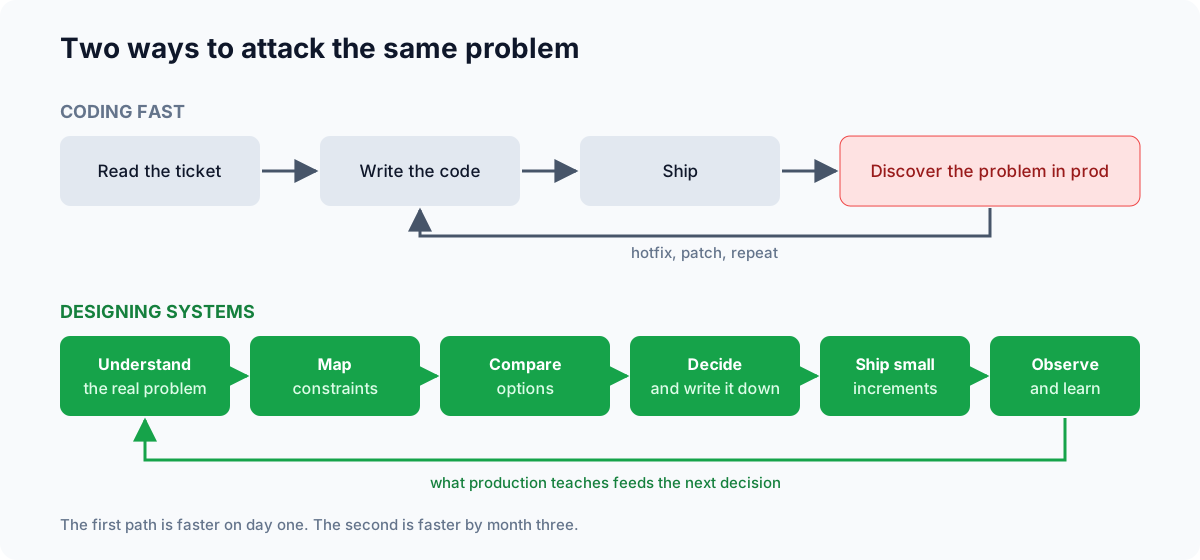
O primeiro caminho é mais rápido no primeiro dia. O segundo é mais rápido no terceiro mês, e muito mais rápido no segundo ano.
IMPORTANT
Desenhar antes não significa desenhar para sempre. A maioria das decisões merece minutos ou horas, não semanas. A habilidade está em saber quais decisões são caras de reverter e gastar o seu tempo de reflexão nelas.
Se você está no começo da carreira
Você não precisa do título de sênior para começar a praticar isso. Alguns hábitos que rendem juros compostos:
- Pergunte "por quê" antes de "como". Entenda o problema que o ticket quer resolver, não só a solução que ele descreve.
- Escreva um trade-off por decisão. Nem que seja na descrição do pull request. Principalmente lá.
- Leia o código ao redor do seu. Entender o sistema é como o raio das suas decisões cresce.
- Acompanhe o seu código até a produção. Olhe os logs, as métricas, os incidentes. Produção é o melhor professor que você vai ter.
- Prefira passos pequenos e reversíveis. Mudanças grandes parecem produtivas. As pequenas é que chegam em produção.
Para levar
- Codar rápido é uma habilidade. A armadilha é transformar velocidade na única métrica.
- Senioridade é o raio das suas decisões, não a complexidade do seu código.
- Toda decisão é um trade-off. Se você não consegue dizer o custo, continue pensando.
- Operabilidade faz parte do design, não é algo que se adiciona depois do incidente.
- Registre as decisões. O seu eu do futuro e o seu time vão agradecer.
Mais de sete anos depois, eu ainda escrevo muito código. Só faço perguntas melhores antes.